Co znamená datová připravenost
Připravenost neznamená jen mít data na jednom místě. Model potřebuje vědět, co s daty dělat, a k tomu potřebuje kontext.
- Metadata a dokumentace. Agent musí vědět, co která tabulka nebo pole znamená. Stejně znějící názvy polí nemusí nutně obsahovat významově stejná data. Například pole “price” může v jednom případě být cena s DPH, ve druhém cena bez DPH a podobně. Bez jasné dokumentace si to model domyslí podle svého. Ani dokumentace ale nestačí, pokud nikdo nekontroluje, že se jí agent drží. Když mu dáte deset instrukcí, občas jich splní devět a desátou zahodí.
- Vysvětlené vztahy mezi zdroji. Jak spolu souvisí CRM, ERP a fakturační systém? Který identifikátor je společný, kde vznikají duplicity, co se stane, když se zákazník objeví ve dvou systémech pod jiným e-mailem nebo názvem firmy.
- Struktura, která říká modelu, kam se dívat. Dobře připravená datová platforma nasměruje model rovnou na relevantní oblast dat, takže na jednoduchou otázku o objednávkách nešmátrá zbytečně i v tabulkách o skladu nebo mzdách.
- Kde je zdroj pravdy. Je potřeba modelu jasně říct, kde je zdroj pravdy a kam se může případně podívat pro ověření. Stejně tak u agregovaných dat musí být jasné, co se agreguje a jaké jsou podmínky agregace.
- Výpočty mimo model. Jazykový model nemá nic počítat. Když se agent ptá na zisk za období nebo má vybírat z katalogu 30 000 produktů, spočítá to deterministický nástroj a model dostane jen výsledek. Všechna čísla by měla procházet verzovanými skripty, které někdo kontroluje. A když není jasné, na co se uživatel ptá, má se agent doptat.
- Vlastnictví, přístupová práva a maskování citlivých dat. Kdo za danou oblast dat odpovídá a kdo k ní má přístup, to musí být jasné dřív, než se k datům připojí model. Stejně důležité je i to, co model smí vrátit v odpovědi. Citlivé údaje (osobní data, mzdy, smlouvy) je potřeba maskovat i tam, kam má agent jinak přístup.
Kde to nejčastěji drhne
- Ruční práce, která zůstala z doby před AI, je prvním z řady častých problémů. Pokud lidé data ručně stahují a lepí v Excelu, žádný spolehlivý automatizovaný zdroj pro AI vůbec neexistuje: výsledkem je jednorázový výstup pro konkrétní report, ne zdroj, ke kterému se dá agent průběžně a spolehlivě připojit. Pomáhá tomu předejít automatizovaná pipeline, která data pravidelně stahuje, čistí a ukládá na jedno místo, odkud může agent čerpat kdykoliv.
- Chybějící byznysový pohled. Dalším typickým problémem je, že projekt vede jen IT tým, bez lidí, kteří rozumí byznysu za daty. Architektura pak vznikne technicky bezchybně, ale nikdo u návrhu neřekl, co která hodnota znamená pro obchod nebo kdy je informace už zastaralá. Po pár měsících se ukáže, že agent odpovídá přesně, jenže na otázky, které firmu vlastně nezajímají. Datovou připravenost proto musí někdo držet napříč všemi stranami. U nás v Etneteře tu roli mám já. Nejsem IT, data ani byznys, a zároveň to musím koordinovat se všemi. Bez IT nebudu mít datový sklad, bez datařů spočítaná data, bez byznysu sémantickou vrstvu a bez compliance nebudu vědět, kdo smí co vidět. A bez uživatelů to celé nebude k ničemu.
- Přehlíží se i náklady. Platforma se postaví technicky správně, ale bez ohledu na cenu od začátku, a po pár měsících provozu přijde faktura za cloud, která přesahuje očekávaný rozpočet. Cenová optimalizace se pak řeší až zpětně, místo aby byla součástí návrhu architektury hned na začátku.
- Chybí údržba. Data se v čase mění: přibudou nové systémy, staré se zruší, byznysové potřeby se posunou. Platforma, která byla připravená před rokem, nemusí stačit dnes, pokud se o ni nikdo průběžně nestará. Objevují se nové nepopsané proměnné, tabulky a hodnoty, a chaos, který firma na začátku vyřešila, se pomalu vrací. Tohle nikdy nebude nikdo dělat ručně. Systém proto musí umět takové změny sám detekovat a ideálně rovnou navrhovat aktualizace, aby zůstal použitelný i za pár měsíců, ne jen v den spuštění.
- Neexistují automatizované testy integrity - nejen té referenční (že jsou data správně spojená mezi různými tabulkami nebo systémy), ale i testy integrity, kdy se např. napočítaný zisk za období nesmí lišit oproti zdrojovému systému. Samostatnou kapitolou jsou testy na bezpečnost / ochranu osobních údajů - jestli se náhodou nějakým nedopatřením nedá dostat k datům, ke kterým by se dotyčný dostat neměl.
Nestrukturovaná data
Samostatnou kapitolu tvoří všechna nestrukturovaná data, která typicky leží na nějakém firemním “knowledge-base” úložišti. Mezi částmi firmy je tu velký rozdíl. Vývoj pracuje s kódem a tabulkami a je mnohem dál než netechnické části firmy, které žijí v Excelu, Wordu a záznamech ze schůzek. Sem patří např.
- nabídky
- smlouvy s klienty
- pracovní postupy
- dokumentace
- šablony dokumentů
- zápisy z porad
- a mnoho dalšího
V AI-first přístupu chcete umět pracovat i s těmito dokumenty, ale tady bývá situace kolikrát ještě horší (a to píšu z vlastní zkušenosti, když vidím, jak vypadá náš firemní Google Drive).
- není jasná vazba na klienta nebo projekt (často jen podle názvu složky / dokumentu)
- u záznamů ze schůzek často není jasné ani to, o kom je řeč. Když v přepisu zazní jen „byl jsem na schůzce v bance”, AI z kontextu těžko pozná, o kterou banku šlo
- není jasné, co z toho je poslední verze (kolikrát se i pracovní dokument před odesláním klientovi zkonvertuje např. do Microsoft Word a od té doby už žije jen svým životem v e-mailových konverzacích)
- spousta dokumentů je už dávno zastaralých, ale nové verze (nebo dokumenty s novými jmény) neříkají jasně, že zneplatňují jiné
Zároveň není dobrý nápad prostě vzít všechno, nalít to do AI a doufat, že z toho nějakým zázrakem pochopí, co s tím má udělat. Sami jsme to s naším Google Drivem zkoušeli a snahu zaindexovat ho celý jsme víceméně vzdali.
Jak začít?
- Audit a zmapování zdrojů. Zjistit, kde všude data leží, v jaké jsou kvalitě a která verze je ta platná.
- Konsolidace a čištění. Sjednotit roztříštěné zdroje do jednoho přehledného celku, odstranit duplicity a nekonzistence.
- Vydefinování oblastí a vlastníků. Rozdělit data podle agend, se kterými bude AI pracovat, a určit, kdo za kterou oblast odpovídá. Tohle je krok, který se často přeskakuje, a přitom právě on rozhoduje o tom, jestli model bude vědět, kam sáhnout.
- Architektura s jasnou navigací. Datový sklad nebo lakehouse postavené tak, aby k němu existovala dokumentace a metadata, ne jen surová data.
- Zabezpečení a přístupová práva. Nastavit, kdo a co smí vidět, ještě než se k datům připojí první model.
- Nastavení testů, monitoringu a automatických aktualizací kontextu. Systém musí poznat, že data a dokumentace se začínají vzdalovat, vydefinovat, co je potřeba udělat, navrhnout řešení a nechat validovat vlastníkem (human in the loop).
- U nestrukturovaných dokumentů doporučujeme jít spíš cestou potřeby - nejdřív si nadefinujte, jaký proces chcete do AI převést a tím získáte, jaké dokumenty potřebuje - my jsme např. při tvorbě agenta pro nabídková řízení kompletně předělali náš archiv nabídek a zpracovali ho do podoby, se kterou už agent umí rozumně pracovat. Prošli jsme přitom deset let nabídek. Bez AI by se do toho nikdo dobrovolně nepouštěl.
Připravenost není jednorázová věc
Nasazením agenta práce nekončí. Vyplatí se sledovat, na co se lidé nejčastěji ptají a kde si agent neporadí. Tato zjištění ukazují, kam infrastrukturu dál doplňovat: kde chybí metadata, kde je potřeba zapojit vlastníka další oblasti, nebo kde stojí za to nahradit ruční zdroj automatizovanou pipeline.
Bezpečná cesta k AI, ne jen připravená data
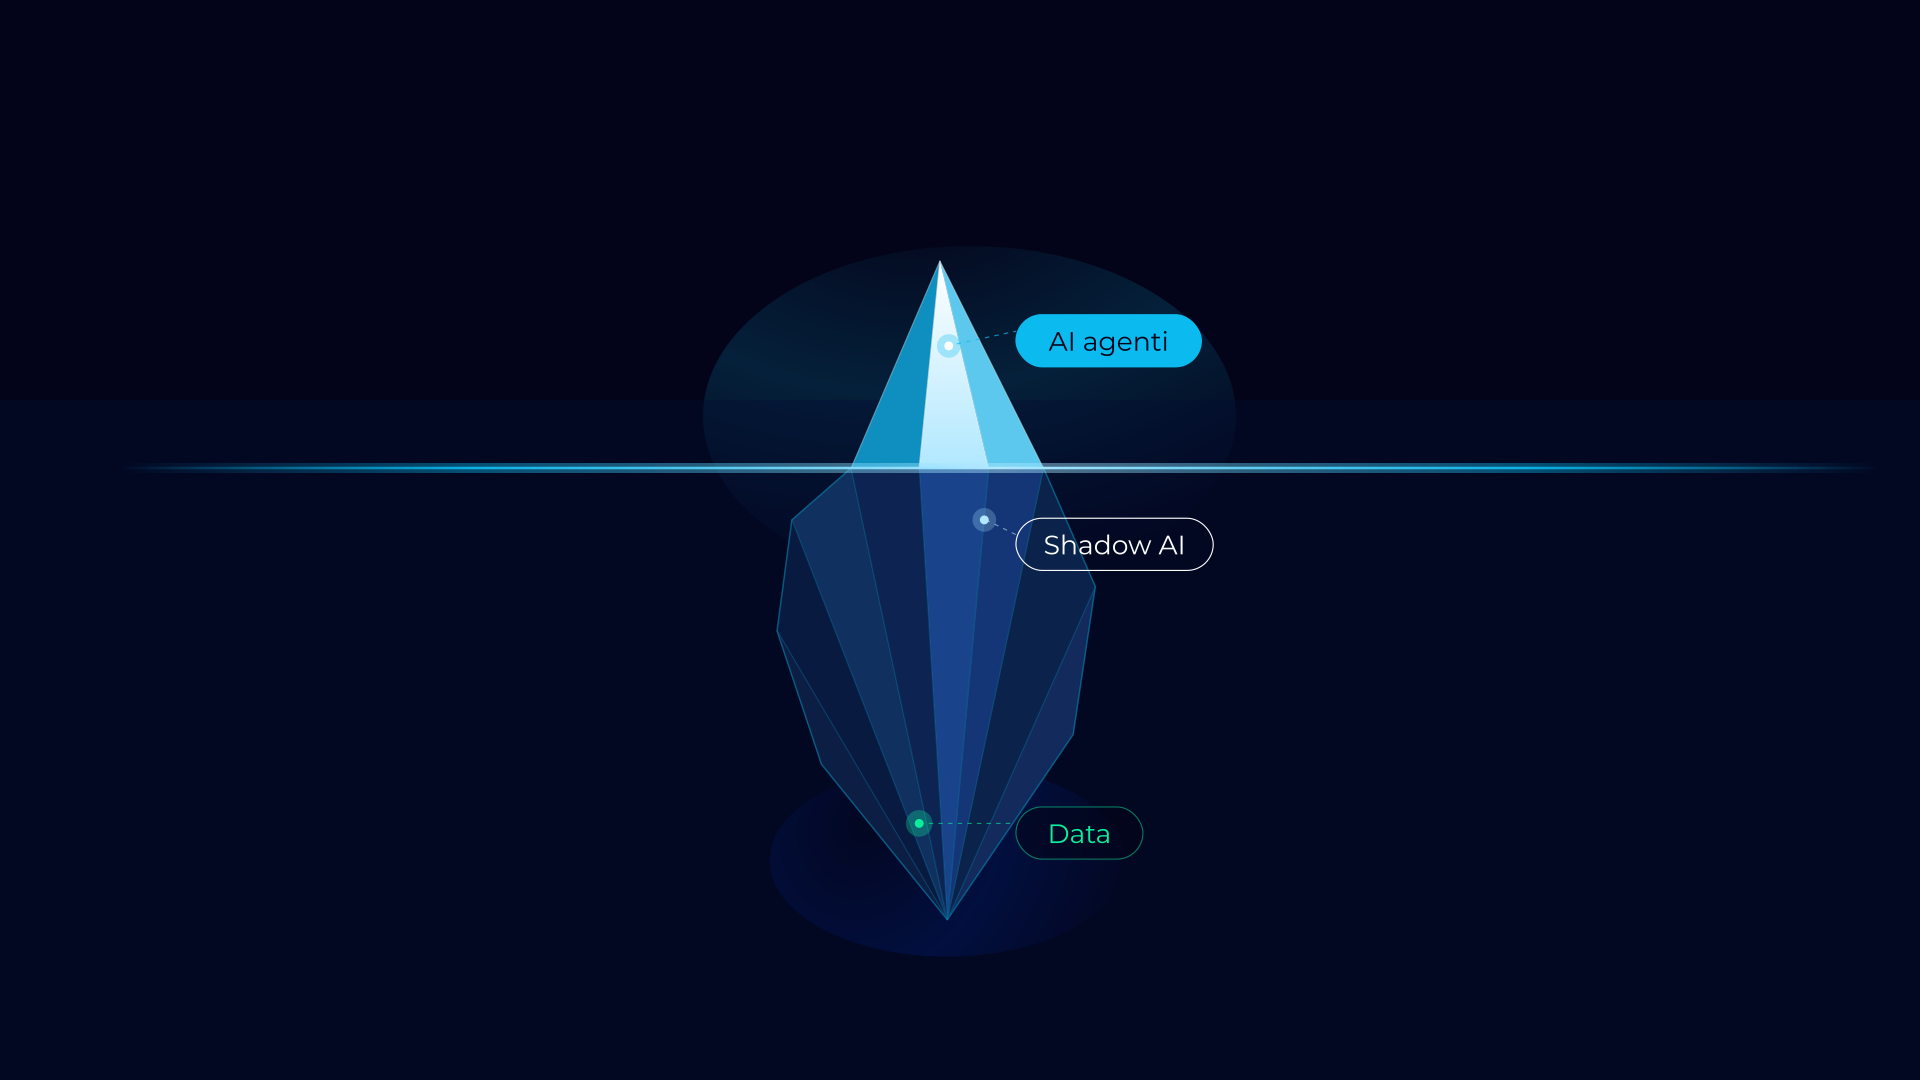
Vlastní AI platforma neřeší jen to, že agent zná vaši firmu. Je to taky oficiální cesta, jak mohou zaměstnanci AI používat bezpečně a pod kontrolou.
Pokud taková cesta chybí, zaměstnanci si stejně nějakou najdou, ať přes veřejně dostupné nástroje, kam nahrají citlivá firemní data, nebo přes vlastní experimenty, o kterých IT vůbec neví. To je bezpečnostní riziko, které firma často odhalí, až je pozdě.
Jak mít správně připravená data a jak postavit cestu, po které mohou zaměstnanci AI využívat bezpečně, jsme probírali na Etnology #6 „Co AI ví? A kdo ji pustil?”. Záznam najdete tady.